最近Jerry老師即將準備完成的新課程,關於強化學習,歡迎大家一起來學習
優惠名額有限動作要快:)
請點預購連結
2020年2月6日 星期四

2019年9月9日 星期一
[ML Study Jam] How Google does Machine Learning的Module 3 Quiz學習日誌之企業導入機器學習的方法
How Google does Machine Learning的學習日誌
最近Google連續辦了兩次ML Study Jam的活動,包含
ML Study Jam 機器學習培訓計劃- 初級- 首頁,以及ML Study Jam 機器學習培訓計劃- 進階-首頁,這兩階段的課程內容,個人覺得非常適合企業在導入ML給同仁必上的內容,尤其適合非科班出身的又想轉型的朋友們。
在進階課程的當中,筆者覺得在「How Google does Machine Learning」當中,有許多有趣的題目與內容,是自己多年做資料科學服務有所共鳴的,希望能夠透過部落格分享學習的心得,提供給想導入ML的企業與想持續學習導入ML的朋友。(請注意本篇文章僅針對部分題目提供心得分享,並非答案分享)
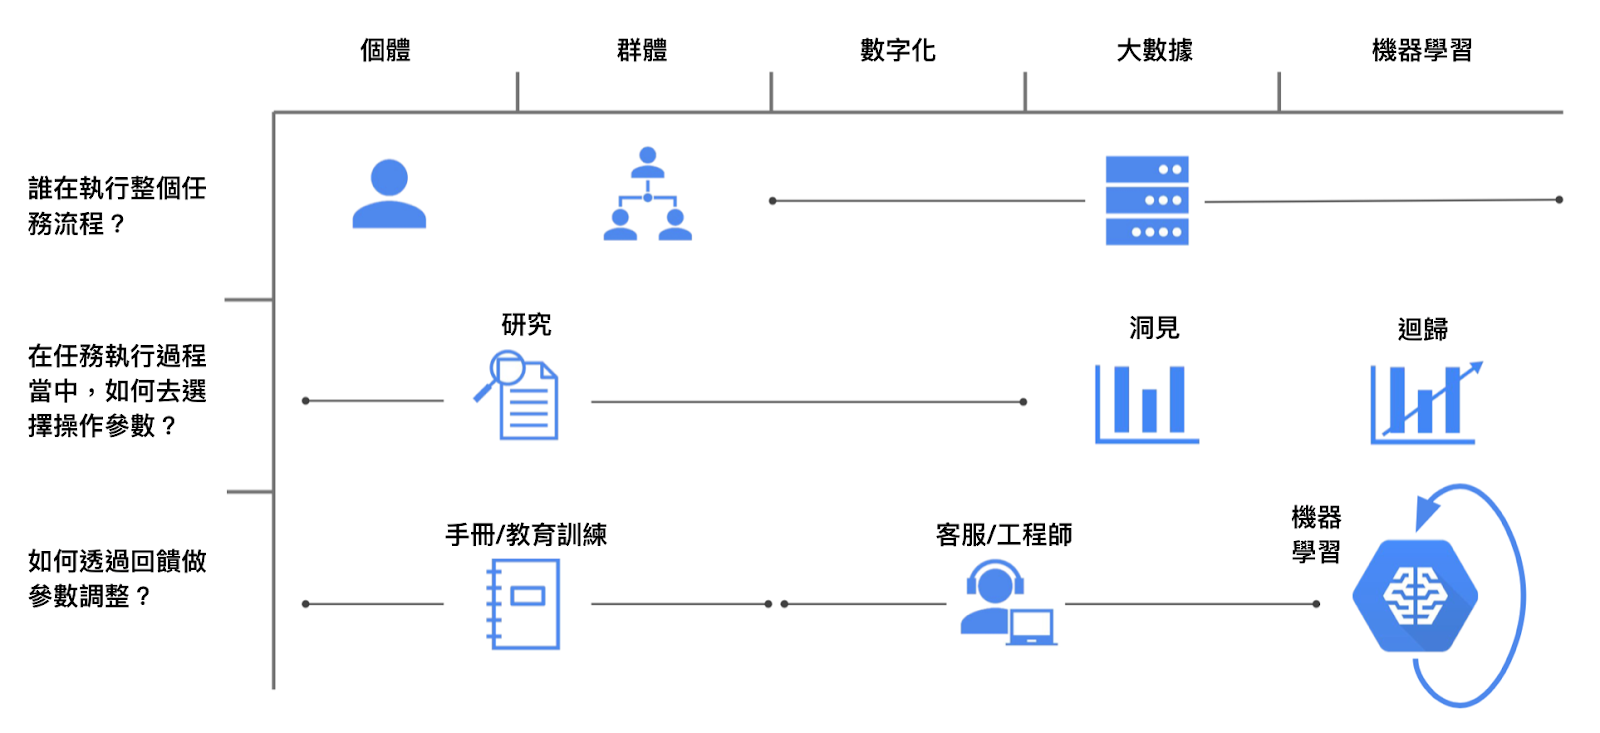
過去筆者在導入多年的資料科學服務當中,發現資料科學家要有一個非常重要的能力,是能夠快速辨識這家企業與題目,到哪一個階段,接著再給予對應的服務內容,避免導入過程資源的浪費,而課程當中Google整理了一個「Path to ML」來幫忙大家釐清企業的ML導入階段。

在Module 3 Quiz的部分,有一題要學員能夠針對題目,以「Path to ML」五階段做辨認,而其中五階段包含「Individual contributor」、「Delegation」、「Digitization」、「Big data and Analytics」、「Machine learning」,在ML and Business Processes課程當中,個人覺得非常好的一個觀念是,企業要導入一個從無ML->有ML的過程,必須先找到流程上的輸入與輸出,接著在輸出中透過數據與ML找出具有洞見的結果,將結果回到流程上去改善輸出。
因此回到「Path to ML」,我們首先要能夠辨認,我們在企業流程中,到底是哪一個階段,才能去藉由階段工作來正確導入ML,筆者整理如下:
I for individual contributor:任務的本體,如單一櫃員
D for delegation:多個可執行任務的人,如多個店員
Z for digitization:數位化的工具,如ATM,可以透過機器進行重複化的工作
B for big data and analytics:透過資料挖掘洞見,提升營運效率,如汽車生產
M for machine learning:透過前面的數據,以機器學習來自動化改善整個營運效益,如推薦系統
聰明的朋友,如果題目如下,您會將上述的I,D,Z,B,M,分別放在哪裡呢?
問題1
製造工廠有許多機械手臂,整個生產團隊透過手臂上收集的數據來幫助確定生產的時間表。
問題2
一個客戶服務團隊持續接收在線上的訂單
問題3
一個圖書館員在城市圖書館工作
問題4
停車收費系統根據可能預期的需求來自動改變費率
問題5
自動電子收費器透過讀取汽車牌照跟駕駛索取過路費(如ETC)
問題1看起來非常明顯是以數據來挖掘洞見,問題2與問題3很容易理解是傳統的運作階段,問題4與問題5比較容易會有誤會是在「digitization」與「machine learning」的差別,但仔細一看,事實上ML有個關鍵是透過數據「自動化」原先的流程,因此會獲得一個不斷改變的輸出,答案就出來了。
看起來大家都有十足的把握了,我們繼續看一下去,如果題目如下,您們的選擇為何?
題目6
所有任務,包含執行參數、選擇參數、參數回饋都是自動化
題目7
一個人在執行任務,而這個任務與指令來自人與人之間的方式運作
題目8
一個電腦執行任務,而軟體工程師透過歷史的模式,來進行參數的調整。
題目9
一個電腦執行過程是透個人從介面上輸入參數來進行。
題目10
一個任務是從一群人來完成
問題6我們可以發現全數自動化,會是機器學習的強項,答案是非常明確的。接著在問題7與問題10的部分,也很容易辨識是傳統1個與多個人的運作方式,最後這次的題目8與題目9分別就相對明顯很多,題目9單純只有透過介面來做互動,而題目8則透過數據挖掘模式來進行參數調整。
最後在Quiz最尾端的題目也非常有趣,題目大意是在說一家企業需要在一年內導入ML,我們是這家企業的顧問,而我們應該請該企業集中資源在哪一個地方,譬如說:「定義關鍵目標」、「收集資料」、「建立基礎設施」、「最佳化演算法」、「整合模型」。
其實有經驗的顧問會選擇「收集資料」,因為這是所有企業導入ML的最重要的問題,尤其以筆者過去的經驗是,傳統企業常常是因為沒有資料而無法導入ML。而其他都不重要嗎?並不是,而是沒有資料,對於定好目標、建立設施、最佳化算法、整合模型就都沒有了意義。
但是筆者提一個觀點是,如果我們企業要導入ML,也不能盲目的收集資料,而是要了解解決什麼問題。
所以回過頭來,一樣可以觀察公司目前的階段,從沒有ML->有ML,我們在「Individual contributor」、「Delegation」、「Digitization」、「Big data and Analytics」、「Machine learning」是哪一個階段,才能將資源妥善運用在導入ML的正確方向當中。
以上是筆者對於「How Google does Machine Learning」的Module 3 Quiz拙見,歡迎討論。
最近Google連續辦了兩次ML Study Jam的活動,包含
ML Study Jam 機器學習培訓計劃- 初級- 首頁,以及ML Study Jam 機器學習培訓計劃- 進階-首頁,這兩階段的課程內容,個人覺得非常適合企業在導入ML給同仁必上的內容,尤其適合非科班出身的又想轉型的朋友們。
在進階課程的當中,筆者覺得在「How Google does Machine Learning」當中,有許多有趣的題目與內容,是自己多年做資料科學服務有所共鳴的,希望能夠透過部落格分享學習的心得,提供給想導入ML的企業與想持續學習導入ML的朋友。(請注意本篇文章僅針對部分題目提供心得分享,並非答案分享)
過去筆者在導入多年的資料科學服務當中,發現資料科學家要有一個非常重要的能力,是能夠快速辨識這家企業與題目,到哪一個階段,接著再給予對應的服務內容,避免導入過程資源的浪費,而課程當中Google整理了一個「Path to ML」來幫忙大家釐清企業的ML導入階段。
在Module 3 Quiz的部分,有一題要學員能夠針對題目,以「Path to ML」五階段做辨認,而其中五階段包含「Individual contributor」、「Delegation」、「Digitization」、「Big data and Analytics」、「Machine learning」,在ML and Business Processes課程當中,個人覺得非常好的一個觀念是,企業要導入一個從無ML->有ML的過程,必須先找到流程上的輸入與輸出,接著在輸出中透過數據與ML找出具有洞見的結果,將結果回到流程上去改善輸出。
因此回到「Path to ML」,我們首先要能夠辨認,我們在企業流程中,到底是哪一個階段,才能去藉由階段工作來正確導入ML,筆者整理如下:
I for individual contributor:任務的本體,如單一櫃員
D for delegation:多個可執行任務的人,如多個店員
Z for digitization:數位化的工具,如ATM,可以透過機器進行重複化的工作
B for big data and analytics:透過資料挖掘洞見,提升營運效率,如汽車生產
M for machine learning:透過前面的數據,以機器學習來自動化改善整個營運效益,如推薦系統
聰明的朋友,如果題目如下,您會將上述的I,D,Z,B,M,分別放在哪裡呢?
問題1
製造工廠有許多機械手臂,整個生產團隊透過手臂上收集的數據來幫助確定生產的時間表。
問題2
一個客戶服務團隊持續接收在線上的訂單
問題3
一個圖書館員在城市圖書館工作
問題4
停車收費系統根據可能預期的需求來自動改變費率
問題5
自動電子收費器透過讀取汽車牌照跟駕駛索取過路費(如ETC)
問題1看起來非常明顯是以數據來挖掘洞見,問題2與問題3很容易理解是傳統的運作階段,問題4與問題5比較容易會有誤會是在「digitization」與「machine learning」的差別,但仔細一看,事實上ML有個關鍵是透過數據「自動化」原先的流程,因此會獲得一個不斷改變的輸出,答案就出來了。
看起來大家都有十足的把握了,我們繼續看一下去,如果題目如下,您們的選擇為何?
題目6
所有任務,包含執行參數、選擇參數、參數回饋都是自動化
題目7
一個人在執行任務,而這個任務與指令來自人與人之間的方式運作
題目8
一個電腦執行任務,而軟體工程師透過歷史的模式,來進行參數的調整。
題目9
一個電腦執行過程是透個人從介面上輸入參數來進行。
題目10
一個任務是從一群人來完成
問題6我們可以發現全數自動化,會是機器學習的強項,答案是非常明確的。接著在問題7與問題10的部分,也很容易辨識是傳統1個與多個人的運作方式,最後這次的題目8與題目9分別就相對明顯很多,題目9單純只有透過介面來做互動,而題目8則透過數據挖掘模式來進行參數調整。
最後在Quiz最尾端的題目也非常有趣,題目大意是在說一家企業需要在一年內導入ML,我們是這家企業的顧問,而我們應該請該企業集中資源在哪一個地方,譬如說:「定義關鍵目標」、「收集資料」、「建立基礎設施」、「最佳化演算法」、「整合模型」。
其實有經驗的顧問會選擇「收集資料」,因為這是所有企業導入ML的最重要的問題,尤其以筆者過去的經驗是,傳統企業常常是因為沒有資料而無法導入ML。而其他都不重要嗎?並不是,而是沒有資料,對於定好目標、建立設施、最佳化算法、整合模型就都沒有了意義。
但是筆者提一個觀點是,如果我們企業要導入ML,也不能盲目的收集資料,而是要了解解決什麼問題。
所以回過頭來,一樣可以觀察公司目前的階段,從沒有ML->有ML,我們在「Individual contributor」、「Delegation」、「Digitization」、「Big data and Analytics」、「Machine learning」是哪一個階段,才能將資源妥善運用在導入ML的正確方向當中。
以上是筆者對於「How Google does Machine Learning」的Module 3 Quiz拙見,歡迎討論。
2018年1月26日 星期五
歡迎加入機器智能實驗室_FB社團
大家好,我是資料科學實驗室作者Jerry,由於個人工作歷程的發展,目前正在從「數據科學」轉移到「機器智能」上發展,所以建立了「機器智能實驗室」,在這裡不同以往的,我們可以有更多的互動與交流,也歡迎大家一起進入我們的研究行列。
未來所有智能化的來源都是資料,而研究多年「資料應用」的Jerry,希望能夠將資料與智能化整合,就像阿里巴巴馬雲說的「以前的電器是插上了電以後就聽你話。未來電器不僅要通電,更要通數據。機器收到數據之後,機器比人變得越來越聰明」。
另外也有牛津大學的學者提到「機器智能將會是我們人類最後一個發明」,讓我更決定開始投入機器智能(Machine Intelligence)的相關研究。
在接下來幾年,資料將會是企業最重要的資產,為了能夠掌握未來發展,企業應該要能夠掌握資料,並開始投入研究資料,進而將資料用在各種智能應用上面。但是因為機器智能(Machine Intelligence)技術越來越複雜,門檻越來越高,因此希望成立機器智能實驗室,希望大家一同共襄盛舉。
======================= [工商服務] =======================
目前JerryWu老師是Google機器學習開發專家,同時擔任機器智能(人工智慧)訓練講師,目前在廣宣學堂、T客邦、資策會、工研院、中國生產力中心、文化大學進修推廣部......等知名訓練機構擔任講師,也同時是亞太智能機器的創辦人兼技術長。
教授課程包含:
機器學習、機器理解、機器視覺、Python基礎課程、Python資料分析課程、預測分析與管理。
有需要的朋友歡迎來信 jerry@ap-mic.com
未來所有智能化的來源都是資料,而研究多年「資料應用」的Jerry,希望能夠將資料與智能化整合,就像阿里巴巴馬雲說的「以前的電器是插上了電以後就聽你話。未來電器不僅要通電,更要通數據。機器收到數據之後,機器比人變得越來越聰明」。
另外也有牛津大學的學者提到「機器智能將會是我們人類最後一個發明」,讓我更決定開始投入機器智能(Machine Intelligence)的相關研究。
在接下來幾年,資料將會是企業最重要的資產,為了能夠掌握未來發展,企業應該要能夠掌握資料,並開始投入研究資料,進而將資料用在各種智能應用上面。但是因為機器智能(Machine Intelligence)技術越來越複雜,門檻越來越高,因此希望成立機器智能實驗室,希望大家一同共襄盛舉。
======================= [工商服務] =======================
目前JerryWu老師是Google機器學習開發專家,同時擔任機器智能(人工智慧)訓練講師,目前在廣宣學堂、T客邦、資策會、工研院、中國生產力中心、文化大學進修推廣部......等知名訓練機構擔任講師,也同時是亞太智能機器的創辦人兼技術長。
教授課程包含:
機器學習、機器理解、機器視覺、Python基礎課程、Python資料分析課程、預測分析與管理。
有需要的朋友歡迎來信 jerry@ap-mic.com
2017年5月8日 星期一
透過雲端工具快速實作情緒分析(Sentiment Analysis)
最近實在是太忙,終於有一點時間可以發文,情緒分析一直是筆者的研究之一。自從兩年前「情緒分析(Sentiment Analysis)的作法與商業價值」獲得高度迴響之後,就一直要找時間分享相關的研究。而剛好這兩年Google推出的自然語言技術越來越成熟,筆者就把使用心得給記錄在這邊。
因此本次實作主要使用Google自然語言API (Cloud Natural Language API)來進行情緒辨識,目前支援簡體中文、繁體中文、英文、法文、德文、義大利文、日文、韓文、葡萄牙文、西班牙文。


第三個就是今天要說的,透過雲端工具來取得情緒分數,做之後的系統運用。
在基本教學前,我們自己的電腦必須準備的環境如下:


因此本次實作主要使用Google自然語言API (Cloud Natural Language API)來進行情緒辨識,目前支援簡體中文、繁體中文、英文、法文、德文、義大利文、日文、韓文、葡萄牙文、西班牙文。
如果您只是是玩玩,想看一下Demo,Google提供兩個地方給大家玩,第一個到官網。

可以自行輸入文字進行辨識情緒。
第二個
或是進到Google API進行API測試,網址請點這裡

透過上方的輸入之後,可以獲得情緒分數的回傳

第三個就是今天要說的,透過雲端工具來取得情緒分數,做之後的系統運用。
在基本教學前,我們自己的電腦必須準備的環境如下:
- Google Cloud Platform帳號
- Python 3以上的版本
- Virtualenv (pip install virtualenv)
- gcloud(依據自己的電腦做安裝,本次範例採用Mac OS X)
- 務必完成gcloud上面的登入設定
首先建立一個虛擬環境,筆者用gNLP為名稱,接著進入虛擬環境,指令如下圖所示:

接著我們要裝一下gcloud的Python套件,我們可以只裝Language的相關套件就行。
pip3 install --upgrade google-cloud-language

接著測試一下google cloud的套件是否正常,進入Python之後打以下指令:
from google.cloud import language

接著可以下載筆者從 範例加工過的程式碼,請點網址

這時候直接執行英文句子沒問題,但是輸入中文句子,就會出現問題,像是下面這張圖所示

大意是說他抓不到回傳的資訊,不過事實是目前中文正在測試,他不回傳您資料,但是有其他撇步可以使用。
接著我們要到套件本身做一下修改,從上面我們可以看到他是呼叫document這個函式,所以我們要到"/Library/Frameworks/Python.framework/Versions/3.6/lib/python3.6/site-packages/google/cloud/language/document.py" 去修改 「document.py」這一個檔案。
打開之後 搜尋「null」看到下面的畫面

將裡面的null改成en,讓google自動偵測語言的機制有了預設值,改完之後存檔案。
再回來執行程式,就大功告成。
範例如下


Score是指情緒分數,Magnitude是指情緒的強度。
記錄一下Google自然語言API (Cloud Natural Language API)的API在一定的呼叫次數下是免費的,計費方式是採用每月1,000個字來做單位,以情緒分析為例,大概超過5,000個字之後就是1元美金,但是文字量越多越便宜,實際的計價方式可參考官方網址。
總結一下
優點:
- 透過Google CNL API來實作辨識情緒,方便又快速,可以讓大部分的工程師、分析師比較不會太忙(ㄅㄠˋ ㄍ ㄢ )。
- 不用理基礎設施問題,過往透過辨識情緒要耗費的運算資源,這部分都不用考慮進去,直接以Serverless的概念運作。
- 可以在五分鐘之內,完成情緒辨識功能,並且在一小時之內上線相關的系統,不用再訓練模型、驗證模型。
缺點:
- 有些複雜的句子目前還不能有效地辨識,像是筆者輸入「這台車真好,可是我從來都不開」情緒辨識的結果居然是正面的,所以中文句子還是有辨識問題。
- 一些具有領域知識的名詞 或是特殊名詞 ,混雜在句子裡面的時候,辨識也不會太準,像是「這台車真的是瞎爆了」這樣的句子也無法正常辨識。
- 透過Google CNL API實作,超過一定的呼叫次數後,就要錢(廢話)。
所以結論還是要請資料科學家幫忙做調整跟修正囉:)
2017年3月5日 星期日
2017年台灣巨量資料(大數據)、資料科學家相關課程
很快的新的一年又開始了,筆者已經持續整理資料科學相關課程長達三年,今年也一樣整理相關課程與上課時間給有需要的朋友查詢。

工研院
- 巨量資料資料分析自動化設計-NoSQL(Cassandra)資料庫系列(2017/03/07~2017/03/08)
- 巨量資料資料分析自動化設計-R實務應用進階課程 (2017/04/13~2017/04/14)
- 巨量資料資料分析自動化設計-製造業專題系列 (2017/05/11~2017/05/12)
- 巨量資料之智慧金融服務設計與分析 (2017/05/16~2017/05/17)
- 巨量資料資料分析自動化設計-Python系列 (2017/06/05~2017/06/06)
資策會
- Big Data資料分析二部曲-R軟體與資料探勘 (2017/03/18~2017/03/19)
- 文字資料探勘實作班 (2017/04/29~2017/04/30)
- Big Data之處理與分析(Hadoop)進階班 (2017/07/15~2017/07/16)
- Big Data資料分析首部曲-R軟體實作 (2017/05/15~2017/05/16)
- Python資料探勘實作 (2017/04/15~2017/04/16)
- Big Data之處理與分析(Hadoop)實務班 (2017/06/10~2017/06/11)
- Elasticsearch分散式系統實務班 (2017/03/04~2017/03/05)
- Spark巨量資料分析實務班 (2017/04/15~2017/04/16)
- Big Data資料分析三部曲-R軟體與資料視覺化 (2017/03/25~2017/03/26)
- R軟體與網頁資料擷取應用 (2017/06/10~2017/06/11)
- 文字資料探勘實作班 (2017/4/29~2017/04/30)
- Big Data資料分析三部曲-R軟體與資料視覺化 (2017/03/25~2017/03/26)
- Big Data之處理與分析(Hadoop)進階班 (2017/07/15~2017/07/16)
- R軟體與串流資料分析 (2017/05/20~2017/05/21)
中國生產力中心
- 掌握市場脈動數據分析大解密 (3/24、5/12、7/14、10/20)
- 預測管理與分析 (5/19、7/25、9/15、11/10)
- 大數據於C2B的應用 (4/14、6/23、8/25、10/24)
- 物聯網與大數據整合應用下的產業機會 (3/17、6/30、9/22、11/24)
三星課程網
- 網路爬蟲技術Python入門實作 (2017/02/18~2017/02/19)
- 大數據資料採礦實作 (2017/03/18~2017/03/19)
臺灣資料科學協會
- 資料探勘速遊 (2017/01/14)
- 給工程師的統計學及資料分析 123 (2017/01/14)
- 手把手教你 R 語言資料分析實務 (2017/01/14)
- 手把手的深度學習實務 (2017/01/15)
- 使用 R 語言建立自己的演算法交易事業 (2017/01/15)
- 人類行為大數據分析:資料科學如何應用在教育及醫療領域 (2017/01/15)
- 智慧城市中的時空大數據應用 (2017/02/11)
- 製造資料科學:從預測性思維到處方性決策 (2017/02/11)
- Machine Learning 機器學習課程 (2017/02/12)
- 手把手的深度學習實務 (2017/02/12)
- 統計學家教你穩紮穩打 R 語言資料分析 (2017/02/11~2017/02/12)
筆者整理這幾年來有發現一些心得,關於大數據或資料科學家課程,有越來越多元化的趨勢,另外除了資策會與工研院有長期開課之外,有不少新的公司或團體也有類似的課程出現,像是臺灣資料科學協會、中國生產力中心、三星課程網。
以上 如有遺漏 歡迎留言告知。
歷年資料參考:
2016年7月17日 星期日
「2016 台灣資料科學愛好者年會」精彩資料總整理(持續更新中)

這幾天(2016/7/14 ~ 2016/7/17)資料科學界在台灣最重要的活動,莫過於2016 台灣資料科學愛好者年會,這已經是每年在台灣資料科學界最大的活動之一,今年的票也是不到一小時就幾乎賣光,對這個活動的歷史有興趣的朋友們可以參考「2015年」、「2014年」,今年的主題相較去年,更有趣,更多元、更多產業上的案例。
除此之外,筆者也發現贊助的公司也變得相當的多,今年贊助公司包含國泰人壽、東森信息科技股份有限公司、玉山金控、funP 雲沛創新集團、HTC、台灣 IBM、新加坡商鈦坦科技 TITANSOFT、潮網科技、Vpon 威朋、宇匯知識、勤業眾信、遊戲橘子、GMobi通用移動、Google、艾肯娛樂、宣捷生物科技、MIGO 功典、Mozilla TW、天氣風險、琅茶,從中我們可以發現不只資訊公司,也包含其他產業的公司,像是生物研究、天氣、會計,甚至是金融業都來加入,整體上台灣資料科學發展的凝聚力,在今年又更上一層樓。
今年筆者一樣秉持著自己也是資料科學愛好的一份子,將今年的資料科學活動內容整理如下,供自己與有興趣的朋友們參考:
- 2016台灣資料科學年會開場投影片
- Riot Games Head of Data Science
- 用數據解決都會城市的停車問題
- 隨機對照實驗在公共領域的應用
- 數據分析在運輸管理之應用
- 大數據下的情緒分析
- 一個賭徒的告白 2:交易策略建構與分析,為何你該賭小一點?
- 從薪酬制度讀 CEO 的行為心理學
- 自己的空氣品質自己量 : 談參與式環境感測的機會與挑戰
- 如何備料:資料的抓取、清理以及串接
- 黃從仁/心理與行為資料中的因與果
- 資料科學與防疫應用的結合 : 以登革熱防治為例
- 資料分析前的奏曲 : 談資料收集的挑戰
- How to approach data science problems from start to end
- 未來城市的任意門 (Mobility on Demand for Future Cities)
- 人類行為訊號處理 : 跨學科 (醫療、教育、心理) 應用實例分享、心得、展望
- 從手機解讀行為與心理
- Crowd Computing for Big and Deep AI
- 智慧型工程管考系統 : 資料分析經驗談
- 音樂資料檢索
- 當語音處理遇上深度學習
- 公私協力的公共服務 - 以資料面詮釋
- 從電腦視覺看人工智慧 : 下一件大事
- 我在智慧交通資料解析的失敗歷程
- It's Not What You Say: It's How You Say It!
- 貓都學得會的手機維修資料分析
- The Growth of a Data Scientist
- Practical Issues in Machine Learning
- 沒有大數據怎麼辦 ? 會計師事務所的小數據科學
- Feature Engineering in Machine Learning
- 漫談 R 的學習挑戰與 R 語言翻轉教室
- 娛樂產業中的資料科學家 : 談資料科學於線上遊戲與職業運動之應用
- 空間數據分析推動精準新農業
- 世代之爭爭什麼 ? 談談如何從調查資料挖掘出豐厚的意義
- 資料視覺化的 20 個小訣竅
相關新聞:
其他相關資訊:
2016年5月22日 星期日
一天上手SparkR
Spark是近幾年在數據分析領域非常火紅的技術,繼上一次「透過Python與Spark做氣象大數據分析」的文章,筆者這次希望分享的是原生Spark 在 R上面的改變,從Spark 1.4版開始對R有較完整的支持,而今年推出的Spark 1.6版上面,可以看到Spark 已經特別為R做了一個專屬的核心,這個核心也只有R才有,其目標就是希望把過去R累積的運算套件無痛移植到Spark上。


另外一個重點是寫R的程式碼邏輯不需變換,因此寫R的資料科學家可以更輕鬆的轉移過去的R程式碼,另外2015年從SparkR 1.4開始已提供66種函式,到Spark1.5提供197個函式,到今年的SparkR 1.6.x版本已提供225種函式,這種增長速度是非常驚人的,因為SparkR 1.4 是去年2015年6月發表,距離筆者寫這篇文章的時間才剛剛準備要滿一年,因此SparkR的發展非常的快速。
接下來我們就來用Windows平台先快快的體驗一下SparkR的威力吧,首先到Spark官網上去下載Spark,透過下圖的點選,下載spark-1.6.1-bin-hadoop2.6.tgz版本。

接下來我們就可以開始使用SparkR,我們先使用下面兩行指令做起手式。
其中sc的第一行可以設定Spark的初始狀態,如:要給Spark的記憶體,詳細可參考SparkR的SparkR.init文件。第二行就是前面筆者提到的SparkContext,主要是從JavaSparkContext做初始化的動作。
接下來我們來玩玩經典的iris例子,首先先把iris的欄位名稱做修改,因為Spark裡面很多「.」的函式,避免出錯,我們先把欄位名稱以「_」取代。
接下來我們產生Spark超強的DataFrame,這對R使用者不陌生,只是這次是使用Spark去產生DataFrame。
接下來我們可以使用head或showDF函式觀察資料。
接下來我們可以透過printSchema去觀察一下資料的架構。
接著我們可以透過head與select去挑選某個欄位的資料,如挑選Sepal_Length。
假設筆者想挑選Sepal_Length大於5.4的資料,可以使用head與filter這兩個函式,這兩個函式用起來有沒有覺得很像R的dplyr呢? 相信R使用者很快就能夠上手SparkR。
如果dplyr您夠了解,那接下來如果我們想計算Sepal_Length的做簡單的Aggregation,就可以使用下面的指令。
當然如果要做廣義線性模型(GLM),SparkR的做法跟原生的R做法是完全一模一樣。
如果還想知道其他的功能,請直接拜訪SparkR的文件
從本篇文章中我們可以快速掌握SparkR的使用,同時也了解到目前SparkR不僅支援資料選擇(Selection)、資料過濾(Filtering)、資料聚合(Aggregation),更已經開始支援Spark MLlib可以進行分散式的機器學習。因此我們可以期待未來R的資料科學家在分散式運算上可以透過SparkR更暢通無阻。
當然實務上真的全部資料都要使用SparkR嗎? 不一定,R在記憶體運算(In-memory computing)的部分也有很強的處理能力,因此有時候單機的記憶體夠多,像是MRO + Math Kernel Library,或是寫法稍微改一下(如矩陣寫法),基本上也無須要動用SparkR,雖然如此,在分散式的環境下SparkR還是有它能發展的舞台,所以讓我們繼續期待下去。

圖1:SparkR架構(來源)
從「SparkR: Scaling R Programs with Spark」這篇期刊文章上可以觀察到,圖1中的R的Spark Context透過R-JVM跟Java Spark Context做溝通,將工作分散到每個有R的Worker上面,透過Spark Executor進行運算,其實有Hadoop MR的味道。
但重點是效率變得更好,程式碼變得更好寫,從效率來看,圖2中SparkR的DataFrame效率跟Scala、Python其實也差不多了,而且做Cache會更快。

圖2:DataFrame的效率比較(來源)
另外一個重點是寫R的程式碼邏輯不需變換,因此寫R的資料科學家可以更輕鬆的轉移過去的R程式碼,另外2015年從SparkR 1.4開始已提供66種函式,到Spark1.5提供197個函式,到今年的SparkR 1.6.x版本已提供225種函式,這種增長速度是非常驚人的,因為SparkR 1.4 是去年2015年6月發表,距離筆者寫這篇文章的時間才剛剛準備要滿一年,因此SparkR的發展非常的快速。
接下來我們就來用Windows平台先快快的體驗一下SparkR的威力吧,首先到Spark官網上去下載Spark,透過下圖的點選,下載spark-1.6.1-bin-hadoop2.6.tgz版本。

首先我們進行環境的設定
Sys.setenv(SPARK_HOME = "C:\\spark") #其中C:\\Spark是您的Spark路徑與目錄名稱
library(SparkR, lib.loc = c(file.path(Sys.getenv("SPARK_HOME"), "R", "lib")))
library(SparkR)
接下來我們就可以開始使用SparkR,我們先使用下面兩行指令做起手式。
sc = sparkR.init();sqlContext = sparkRSQL.init(sc)
其中sc的第一行可以設定Spark的初始狀態,如:要給Spark的記憶體,詳細可參考SparkR的SparkR.init文件。第二行就是前面筆者提到的SparkContext,主要是從JavaSparkContext做初始化的動作。
接下來我們來玩玩經典的iris例子,首先先把iris的欄位名稱做修改,因為Spark裡面很多「.」的函式,避免出錯,我們先把欄位名稱以「_」取代。
newiris = iris;names(newiris) = c("Sepal_Length","Sepal_Width","Petal_Length","Petal_Width","Species")
接下來我們產生Spark超強的DataFrame,這對R使用者不陌生,只是這次是使用Spark去產生DataFrame。
df = createDataFrame(sqlContext, newiris)
接下來我們可以使用head或showDF函式觀察資料。
head(df, 5)
showDF(df, 5)
接下來我們可以透過printSchema去觀察一下資料的架構。
printSchema(df)
接著我們可以透過head與select去挑選某個欄位的資料,如挑選Sepal_Length。
head(select(df, df$Sepal_Length))
head(select(df, df$Sepal_Length),10) #挑選10筆
假設筆者想挑選Sepal_Length大於5.4的資料,可以使用head與filter這兩個函式,這兩個函式用起來有沒有覺得很像R的dplyr呢? 相信R使用者很快就能夠上手SparkR。
head(filter(df, df$Sepal_Length > 5.4))
如果dplyr您夠了解,那接下來如果我們想計算Sepal_Length的做簡單的Aggregation,就可以使用下面的指令。
sepal_counts = summarize(groupBy(df, df$Sepal_Length), count = n(df$Sepal_Length))
當然如果要做廣義線性模型(GLM),SparkR的做法跟原生的R做法是完全一模一樣。
model = glm(Sepal_Length ~., data = df, family = "gaussian");summary(model)
如果還想知道其他的功能,請直接拜訪SparkR的文件
從本篇文章中我們可以快速掌握SparkR的使用,同時也了解到目前SparkR不僅支援資料選擇(Selection)、資料過濾(Filtering)、資料聚合(Aggregation),更已經開始支援Spark MLlib可以進行分散式的機器學習。因此我們可以期待未來R的資料科學家在分散式運算上可以透過SparkR更暢通無阻。
當然實務上真的全部資料都要使用SparkR嗎? 不一定,R在記憶體運算(In-memory computing)的部分也有很強的處理能力,因此有時候單機的記憶體夠多,像是MRO + Math Kernel Library,或是寫法稍微改一下(如矩陣寫法),基本上也無須要動用SparkR,雖然如此,在分散式的環境下SparkR還是有它能發展的舞台,所以讓我們繼續期待下去。
訂閱:
文章 (Atom)