2020年3月12日 星期四

五分鐘掌握2020的TensorFlow新發展-生態圈篇

很快的2020的TensorFlow研討會又開始了,筆者先整理目前至今最新的
TensorFlow生態系統,跟相關連結給大家先瞧瞧,後續再整理這次研討會的發現。


TensorFlow Core:TF核心程式碼
TensorFlow JS:可應用JS
TensorFlow Lite:可應用手機、邊緣計算
TensorFlow Lite Micro:可應用單晶片或更小的處理器
TensorFlow Board:視覺化工具
TensorFlow Hub 可重複利用的模型平台
TensorFlow Extended 管理資料流程
tf.keras、tf.data、TF Runtime 能夠幫助我們快速分析的TF套件
Colab :這個超級夯的線上的Google版 Ipython Notebook
TensorFlow Research Cloud 專門給研究用免費使用TPU的計畫
MLIR:高效能的機器學習編譯器
TensorFlow Lattice:可以用來解釋模型的工具
TensorFlow Optimization Toolkit :應用在邊緣計算設備的模型的效能優化工具
TensorFlow Graphics:可以被用來各種不同的神經網路的處理函式,像是convolutions
TensorFlow Probability (TFP) :可以直接將機率模型與深度學習整合到TPU、GPU
Tensor2Tensor:應用於Google Brain團隊加速ML研究的套件
TensorFlow Agents :應用於強化學習的套件
Dopamine:新的學習框架應用於強化學習
TRFL: 可以在GPU上運作的強化學習套件
Mesh-TensorFlow:平行處理能力的套件
Ragged tensors:能夠處理不同資料的張量
TensorFlow (Learning-to-Rank):專門用做模型排序
Magenta:專門用於音樂相關的機器學習套件
Nucleus:專門用於DNA分析的套件
TensorFlow Federated:用於聯合學習(Federated Learning)的套件
TensorFlow Privacy:針對Privacy機器學習相關的套件
TensorFlow fairness:針對機器學習公平性指標的分析套件
Sonnet :用於建構複雜神經網路的套件
Neural Structured Learning (NSL) :一種神經結構化學習方法的套件
JAX:專門用於GPU、TPU高效能運算的套件
TensorFlow Quantum:用於量子模型的機器學習框架
Hass.io Add-on:用於圖像處理的套件


筆者: JerryWu - Google Developers Experts (Machine Learning) 、APMIC OpenTalk創辦人兼執行長

2020年3月6日 星期五

五分鐘學會在Colab上使用免費的TPU訓練模型

哈囉大家好,雖然忙碌,還是趁空擋想跟大家分享關於TensorFlow2.1.x系列的兩三事,一般來說做機器學習模型最需要的就是運算資源,而除了GPU之外,大家一定很想使用Google所推出的Google Cloud TPU來做機器學習模型,重點它很貴,能不能免費的使用他呢?使用Colab就是首選了。

而這次TF2.1新版推出之後,TPU使用有了一個很大幅度的改版,在Colab上使用TPU已經變得非常的容易與簡單,這邊就讓Jerry老師來跟大家娓娓道來。

首先不要忘記在Edit -> Notebook settings 要把硬體調整成TPU,如下圖:

然後就會獲得TPU資源,如下圖:


首先幾個在Colab上要跑TPU的API要了解一下:
1.tf.distribute.cluster_resolver.TPUClusterResolver()
這是負責偵測TPU,可以透過該指令了解Google TPU集群的狀況。

2.tf.config.experimental_connect_to_cluster(tpu)
這是負責連結Google雲端的TPU環境

3.tf.tpu.experimental.initialize_tpu_system(tpu)
這是負責初始化TPU的裝置

所以前置作業如下:

必須設定TensorFlow2.x 以及設定tpu的變數。

接下來要使用TPU,目前模型有固定的寫法,必須寫成函式,舉例如下:

資料的部分也是要寫成函式,這邊範例是採用mnist,所以舉例如下:

最後是訓練模型的程式碼,有個重點是
4.tf.distribute.experimental.TPUStrategy
是呼叫前面TPU分配策略的指令,所以要搭配在程式碼當中

5.strategy.scope()
搭配這段程式碼,可以把模型與要計算的優化器、衡量標準放到運算引擎上

如下:


目前實測的結果,如果以mnist資料為例,
TPU:36秒
GPU(P100):90秒
CPU:291秒

使用心得是,程式碼不用改動太多,在TensorFlow 2.x的架構下,可以很快的進行訓練,程式碼也可以很快速地調整,以後大家就可以用前所未有的速度訓練模型囉!

當然如果您很想更近一步了解Google Cloud Platform上面的TPU費用,可以參考下面連結

相關程式碼請參考

2020年2月6日 星期四

關於Jerry老師的強化學習課程

最近Jerry老師即將準備完成的新課程,關於強化學習,歡迎大家一起來學習
優惠名額有限動作要快:)
請點預購連結


2019年9月9日 星期一

[ML Study Jam] How Google does Machine Learning的Module 3 Quiz學習日誌之企業導入機器學習的方法

How Google does Machine Learning的學習日誌

最近Google連續辦了兩次ML Study Jam的活動,包含
ML Study Jam 機器學習培訓計劃- 初級- 首頁,以及ML Study Jam 機器學習培訓計劃- 進階-首頁,這兩階段的課程內容,個人覺得非常適合企業在導入ML給同仁必上的內容,尤其適合非科班出身的又想轉型的朋友們。

在進階課程的當中,筆者覺得在「How Google does Machine Learning」當中,有許多有趣的題目與內容,是自己多年做資料科學服務有所共鳴的,希望能夠透過部落格分享學習的心得,提供給想導入ML的企業與想持續學習導入ML的朋友。(請注意本篇文章僅針對部分題目提供心得分享,並非答案分享)


過去筆者在導入多年的資料科學服務當中,發現資料科學家要有一個非常重要的能力,是能夠快速辨識這家企業與題目,到哪一個階段,接著再給予對應的服務內容,避免導入過程資源的浪費,而課程當中Google整理了一個「Path to ML」來幫忙大家釐清企業的ML導入階段。

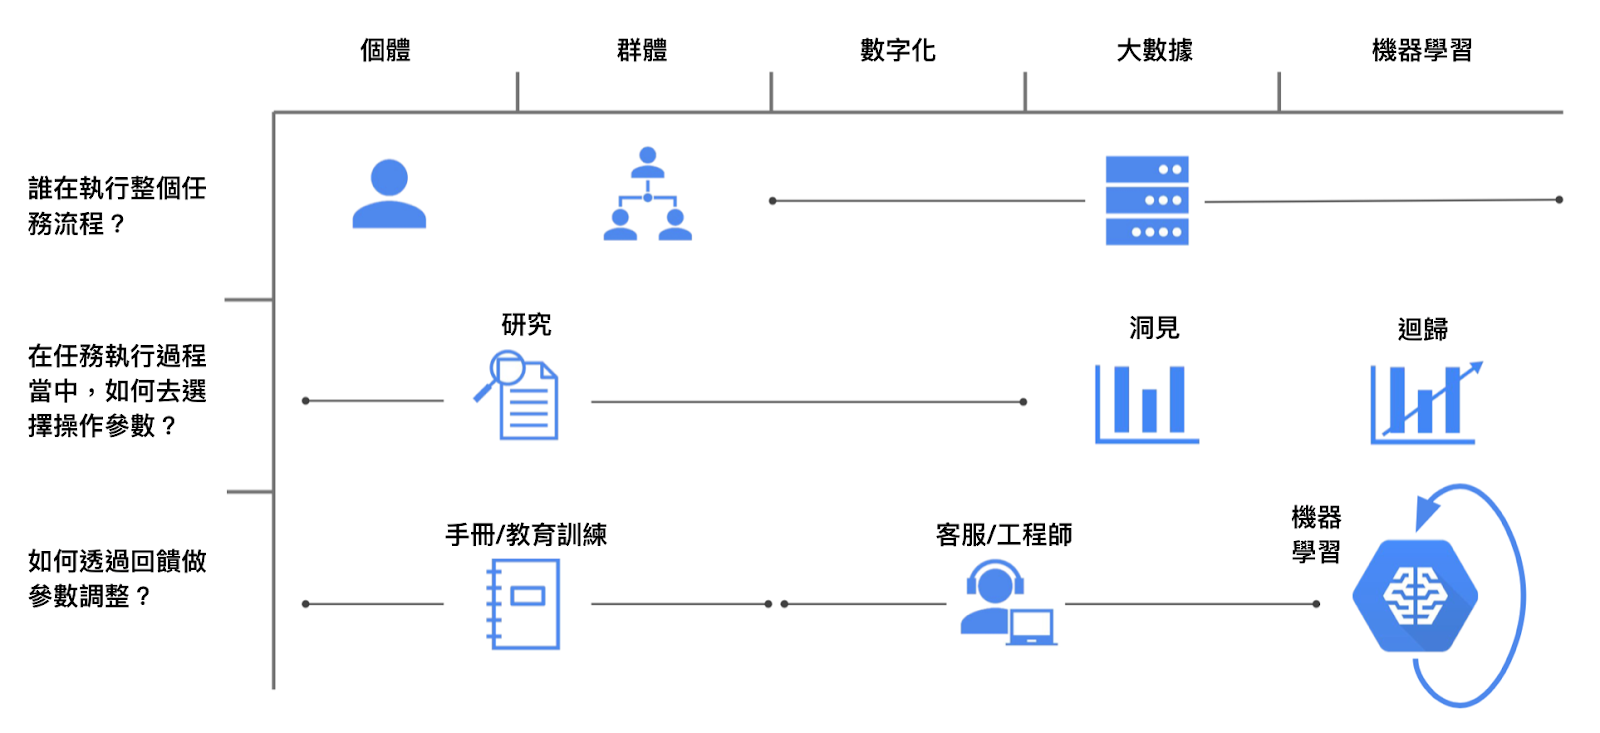
在Module 3 Quiz的部分,有一題要學員能夠針對題目,以「Path to ML」五階段做辨認,而其中五階段包含「Individual contributor」、「Delegation」、「Digitization」、「Big data and Analytics」、「Machine learning」,在ML and Business Processes課程當中,個人覺得非常好的一個觀念是,企業要導入一個從無ML->有ML的過程,必須先找到流程上的輸入與輸出,接著在輸出中透過數據與ML找出具有洞見的結果,將結果回到流程上去改善輸出。

因此回到「Path to ML」,我們首先要能夠辨認,我們在企業流程中,到底是哪一個階段,才能去藉由階段工作來正確導入ML,筆者整理如下:

I for individual contributor:任務的本體,如單一櫃員
D for delegation:多個可執行任務的人,如多個店員
Z for digitization:數位化的工具,如ATM,可以透過機器進行重複化的工作
B for big data and analytics:透過資料挖掘洞見,提升營運效率,如汽車生產
M for machine learning:透過前面的數據,以機器學習來自動化改善整個營運效益,如推薦系統

聰明的朋友,如果題目如下,您會將上述的I,D,Z,B,M,分別放在哪裡呢?

問題1
製造工廠有許多機械手臂,整個生產團隊透過手臂上收集的數據來幫助確定生產的時間表。
問題2
一個客戶服務團隊持續接收在線上的訂單
問題3
一個圖書館員在城市圖書館工作
問題4
停車收費系統根據可能預期的需求來自動改變費率
問題5
自動電子收費器透過讀取汽車牌照跟駕駛索取過路費(如ETC)

問題1看起來非常明顯是以數據來挖掘洞見,問題2與問題3很容易理解是傳統的運作階段,問題4與問題5比較容易會有誤會是在「digitization」與「machine learning」的差別,但仔細一看,事實上ML有個關鍵是透過數據「自動化」原先的流程,因此會獲得一個不斷改變的輸出,答案就出來了。


看起來大家都有十足的把握了,我們繼續看一下去,如果題目如下,您們的選擇為何?

題目6
所有任務,包含執行參數、選擇參數、參數回饋都是自動化
題目7
一個人在執行任務,而這個任務與指令來自人與人之間的方式運作
題目8
一個電腦執行任務,而軟體工程師透過歷史的模式,來進行參數的調整。
題目9
一個電腦執行過程是透個人從介面上輸入參數來進行。
題目10
一個任務是從一群人來完成

問題6我們可以發現全數自動化,會是機器學習的強項,答案是非常明確的。接著在問題7與問題10的部分,也很容易辨識是傳統1個與多個人的運作方式,最後這次的題目8與題目9分別就相對明顯很多,題目9單純只有透過介面來做互動,而題目8則透過數據挖掘模式來進行參數調整。


最後在Quiz最尾端的題目也非常有趣,題目大意是在說一家企業需要在一年內導入ML,我們是這家企業的顧問,而我們應該請該企業集中資源在哪一個地方,譬如說:「定義關鍵目標」、「收集資料」、「建立基礎設施」、「最佳化演算法」、「整合模型」。

其實有經驗的顧問會選擇「收集資料」,因為這是所有企業導入ML的最重要的問題,尤其以筆者過去的經驗是,傳統企業常常是因為沒有資料而無法導入ML。而其他都不重要嗎?並不是,而是沒有資料,對於定好目標、建立設施、最佳化算法、整合模型就都沒有了意義。

但是筆者提一個觀點是,如果我們企業要導入ML,也不能盲目的收集資料,而是要了解解決什麼問題。
所以回過頭來,一樣可以觀察公司目前的階段,從沒有ML->有ML,我們在「Individual contributor」、「Delegation」、「Digitization」、「Big data and Analytics」、「Machine learning」是哪一個階段,才能將資源妥善運用在導入ML的正確方向當中。

以上是筆者對於「How Google does Machine Learning」的Module 3 Quiz拙見,歡迎討論。

2018年1月26日 星期五

歡迎加入機器智能實驗室_FB社團

大家好,我是資料科學實驗室作者Jerry,由於個人工作歷程的發展,目前正在從「數據科學」轉移到「機器智能」上發展,所以建立了「機器智能實驗室」,在這裡不同以往的,我們可以有更多的互動與交流,也歡迎大家一起進入我們的研究行列。

未來所有智能化的來源都是資料,而研究多年「資料應用」的Jerry,希望能夠將資料與智能化整合,就像阿里巴巴馬雲說的「以前的電器是插上了電以後就聽你話。未來電器不僅要通電,更要通數據。機器收到數據之後,機器比人變得越來越聰明」。

另外也有牛津大學的學者提到「機器智能將會是我們人類最後一個發明」,讓我更決定開始投入機器智能(Machine Intelligence)的相關研究。

在接下來幾年,資料將會是企業最重要的資產,為了能夠掌握未來發展,企業應該要能夠掌握資料,並開始投入研究資料,進而將資料用在各種智能應用上面。但是因為機器智能(Machine Intelligence)技術越來越複雜,門檻越來越高,因此希望成立機器智能實驗室,希望大家一同共襄盛舉。


======================= [工商服務] =======================
目前JerryWu老師是Google機器學習開發專家,同時擔任機器智能(人工智慧)訓練講師,目前在廣宣學堂、T客邦、資策會、工研院、中國生產力中心、文化大學進修推廣部......等知名訓練機構擔任講師,也同時是亞太智能機器的創辦人兼技術長。
教授課程包含:
機器學習、機器理解、機器視覺、Python基礎課程、Python資料分析課程、預測分析與管理。

有需要的朋友歡迎來信 jerry@ap-mic.com


2017年5月8日 星期一

透過雲端工具快速實作情緒分析(Sentiment Analysis)

最近實在是太忙,終於有一點時間可以發文,情緒分析一直是筆者的研究之一。自從兩年前「情緒分析(Sentiment Analysis)的作法與商業價值」獲得高度迴響之後,就一直要找時間分享相關的研究。而剛好這兩年Google推出的自然語言技術越來越成熟,筆者就把使用心得給記錄在這邊。

因此本次實作主要使用Google自然語言API (Cloud Natural Language API)來進行情緒辨識,目前支援簡體中文、繁體中文、英文、法文、德文、義大利文、日文、韓文、葡萄牙文、西班牙文。


如果您只是是玩玩,想看一下Demo,Google提供兩個地方給大家玩,第一個到官網。
可以自行輸入文字進行辨識情緒。

第二個
或是進到Google API進行API測試,網址請點這裡
透過上方的輸入之後,可以獲得情緒分數的回傳


第三個就是今天要說的,透過雲端工具來取得情緒分數,做之後的系統運用。

在基本教學前,我們自己的電腦必須準備的環境如下:

  1. Google Cloud Platform帳號
  2. Python 3以上的版本
  3. Virtualenv (pip install virtualenv)
  4. gcloud(依據自己的電腦做安裝,本次範例採用Mac OS X)
  5. 務必完成gcloud上面的登入設定
首先建立一個虛擬環境,筆者用gNLP為名稱,接著進入虛擬環境,指令如下圖所示:

接著我們要裝一下gcloud的Python套件,我們可以只裝Language的相關套件就行。
pip3 install --upgrade google-cloud-language


接著測試一下google cloud的套件是否正常,進入Python之後打以下指令:
from google.cloud import language

接著可以下載筆者從 範例加工過的程式碼,請點網址

這時候直接執行英文句子沒問題,但是輸入中文句子,就會出現問題,像是下面這張圖所示
大意是說他抓不到回傳的資訊,不過事實是目前中文正在測試,他不回傳您資料,但是有其他撇步可以使用。

接著我們要到套件本身做一下修改,從上面我們可以看到他是呼叫document這個函式,所以我們要到"/Library/Frameworks/Python.framework/Versions/3.6/lib/python3.6/site-packages/google/cloud/language/document.py" 去修改 「document.py」這一個檔案。

打開之後 搜尋「null」看到下面的畫面

將裡面的null改成en,讓google自動偵測語言的機制有了預設值,改完之後存檔案。

再回來執行程式,就大功告成。
範例如下


Score是指情緒分數,Magnitude是指情緒的強度。

記錄一下Google自然語言API (Cloud Natural Language API)的API在一定的呼叫次數下是免費的,計費方式是採用每月1,000個字來做單位,以情緒分析為例,大概超過5,000個字之後就是1元美金,但是文字量越多越便宜,實際的計價方式可參考官方網址。

總結一下

優點:
  1. 透過Google CNL API來實作辨識情緒,方便又快速,可以讓大部分的工程師、分析師比較不會太忙(ㄅㄠˋ ㄍ ㄢ  )。
  2. 不用理基礎設施問題,過往透過辨識情緒要耗費的運算資源,這部分都不用考慮進去,直接以Serverless的概念運作。
  3. 可以在五分鐘之內,完成情緒辨識功能,並且在一小時之內上線相關的系統,不用再訓練模型、驗證模型。
缺點:
  1. 有些複雜的句子目前還不能有效地辨識,像是筆者輸入「這台車真好,可是我從來都不開」情緒辨識的結果居然是正面的,所以中文句子還是有辨識問題。
  2. 一些具有領域知識的名詞 或是特殊名詞 ,混雜在句子裡面的時候,辨識也不會太準,像是「這台車真的是瞎爆了」這樣的句子也無法正常辨識。
  3. 透過Google CNL API實作,超過一定的呼叫次數後,就要錢(廢話)。
所以結論還是要請資料科學家幫忙做調整跟修正囉:)


2017年3月5日 星期日

2017年台灣巨量資料(大數據)、資料科學家相關課程


很快的新的一年又開始了,筆者已經持續整理資料科學相關課程長達三年,今年也一樣整理相關課程與上課時間給有需要的朋友查詢。


工研院

資策會

中國生產力中心

三星課程網

臺灣資料科學協會


筆者整理這幾年來有發現一些心得,關於大數據或資料科學家課程,有越來越多元化的趨勢,另外除了資策會與工研院有長期開課之外,有不少新的公司或團體也有類似的課程出現,像是臺灣資料科學協會、中國生產力中心、三星課程網。

以上 如有遺漏 歡迎留言告知。


歷年資料參考: